先从一场股灾说起
2025 年 1 月 27 日,英伟达股价单日暴跌约 17%,市值蒸发近 6000 亿美元,创下当时美股历史最大单日市值损失。引发市场震动的关键因素之一,是一家杭州公司几天前刚开源的模型——DeepSeek-R1:它让投资者重新评估,高水平 AI 是否一定要靠此前设想的巨额算力投入。

那几天,连我家的家族群都在转“DeepSeek 爆了”。但听得多了,你会发现一个有意思的现象:同一个人嘴里的“DeepSeek”,前一句指手机里那个 App,后一句指模型本身,再后一句又变成了“用 DeepSeek 帮我写周报的那个智能体”。
这真不能怪大家。AI、模型、Agent、Harness,这四个词本来就长在完全不同的层面上,却天天被当成同义词搅在一起。这篇文章就把它们放回各自的历史里,一个一个拆开——顺便回答开头埋下的问题:你说的 DeepSeek,到底是哪个 DeepSeek?
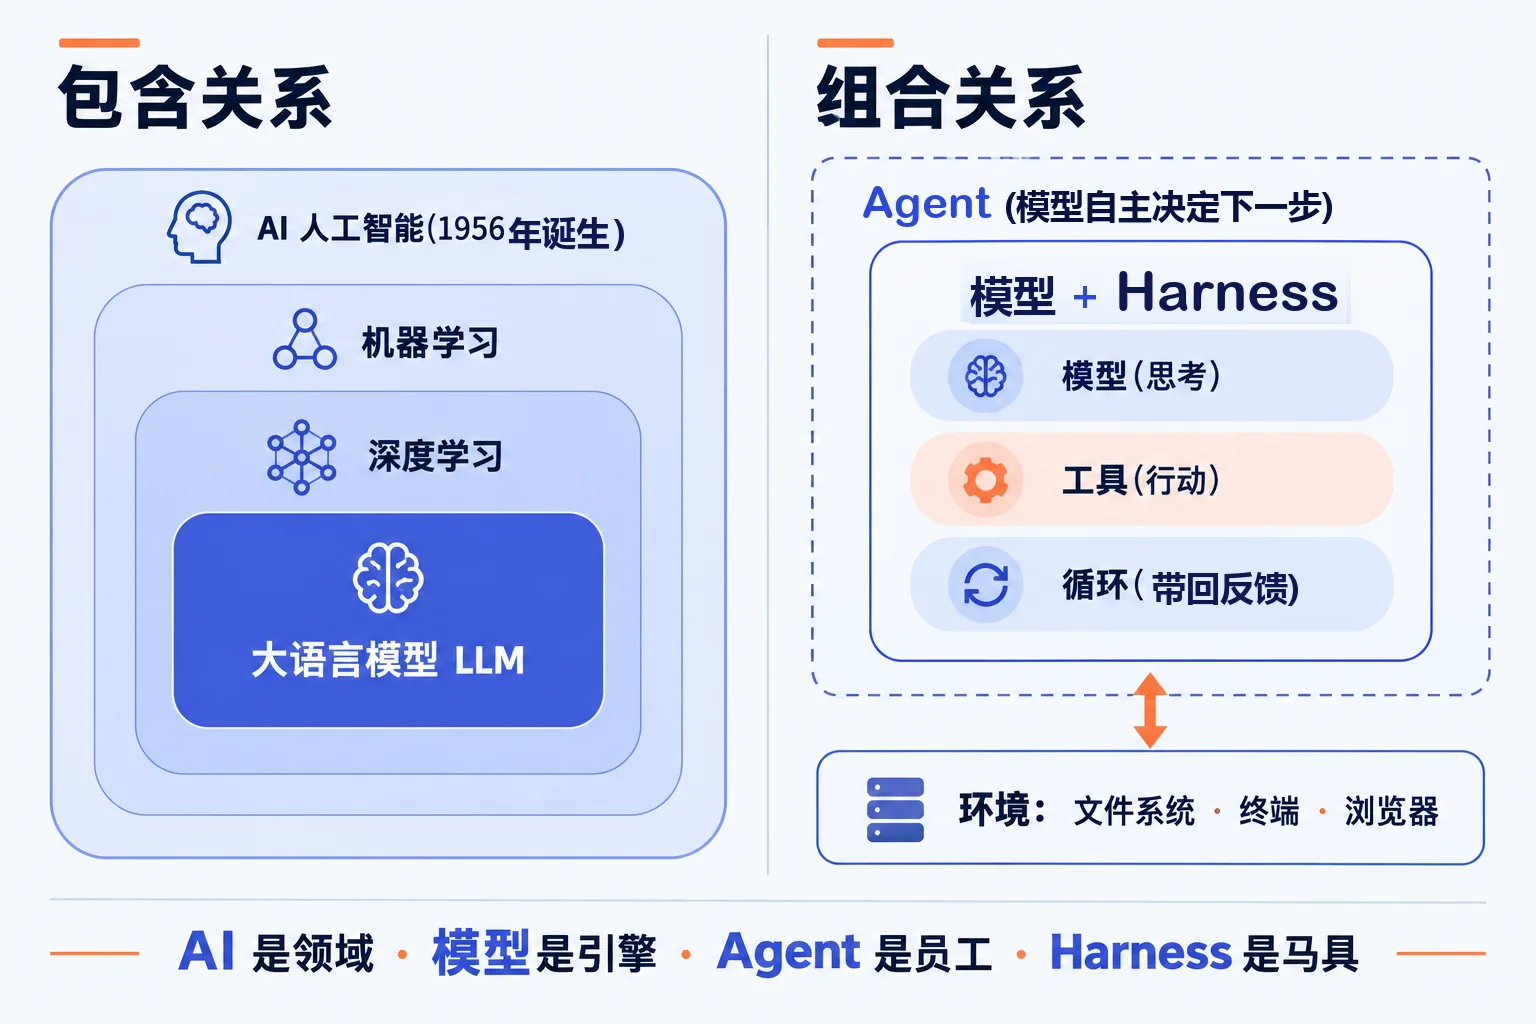
先给一句粗略的关系判断:AI 是一个研究领域,模型提供能力;模型在 Harness 提供的运行机制支持下,可以组成能够自主推进任务的 Agent。全篇就按这条线讲,先上地图:
AI:一个 70 岁还在出爆款的老学科
1950 年,图灵发表《Computing Machinery and Intelligence》,没跟人争论“机器能不能思考”这种哲学问题,而是换了个可操作的判法:如果你在对话里分不清对面是人还是机器,那该不该承认它在思考?这就是图灵测试。
顺便说个你几乎天天都在参与的冷知识:许多用来区分真人与机器人的验证码(CAPTCHA),常被称为反向图灵测试——只不过这回是机器在验证“你是人”。图灵七十多年前设想的那种人机边界测试,就这么润物细无声地进了每个人的生活。
“Artificial Intelligence”这个名字,已经出现在麦卡锡等人 1955 年 8 月提交的达特茅斯夏季研究项目提案里(项目提案上署名的还有信息论之父香农)。1956 年夏天那场研讨会本身没产出什么惊人成果,但常被视为人工智能作为独立研究领域诞生的标志。起名这件事,从来都很重要。
之后七十年的主线,可以粗略看成两条思路先后唱主角:
- 人写规则:1997 年深蓝击败国际象棋世界冠军卡斯帕罗夫,是这条思路的巅峰。它把高速搜索、人工设计的评估函数和棋类知识结合起来,本质上是一台为下棋深度定制的搜索机器——它的“智能”,几乎每一点都出自工程师的设计。
- 从数据里学:2016 年 AlphaGo 战胜李世石,靠的是深度神经网络、人类棋谱、自我对弈强化学习,外加蒙特卡洛树搜索——越来越多的判断能力,从数据和对弈里学了出来。2016 年底至 2017 年初,升级版 Master 在网上取得 60 连胜;2017 年 5 月,柯洁在乌镇三番棋中以 0:3 告负,并曾在第三局比赛中落泪。同一个目标,换了一条思路,20 年后走通了。
中间还夹着两次“AI 寒冬”(约 1974–1980、1987–1993),剧情都一样:牛皮吹出去了,兑现不了,经费撤了,全场冷却。
记住这一句:AI 不是一样东西,是一门研究“如何让机器表现出智能”的学科。七十年里研究重点换了一茬又一茬,新老方法长期并存,目标本身没变过。
模型:DeepSeek 到底是“谁”?
现在回答前面的问题。严格来说,“DeepSeek”是一家公司(深度求索,2023 年成立);2024 年 12 月的 V3、2025 年 1 月的 R1,才是“模型”;你手机里那个蓝鲸图标的 App,是模型外面套的一层产品。公司、模型、产品,三层东西共用一个名字,混用的噩梦从这儿就开始了。
模型是怎么来的?粗看是一条从“人教机器”到“机器自学”的技术脉络:
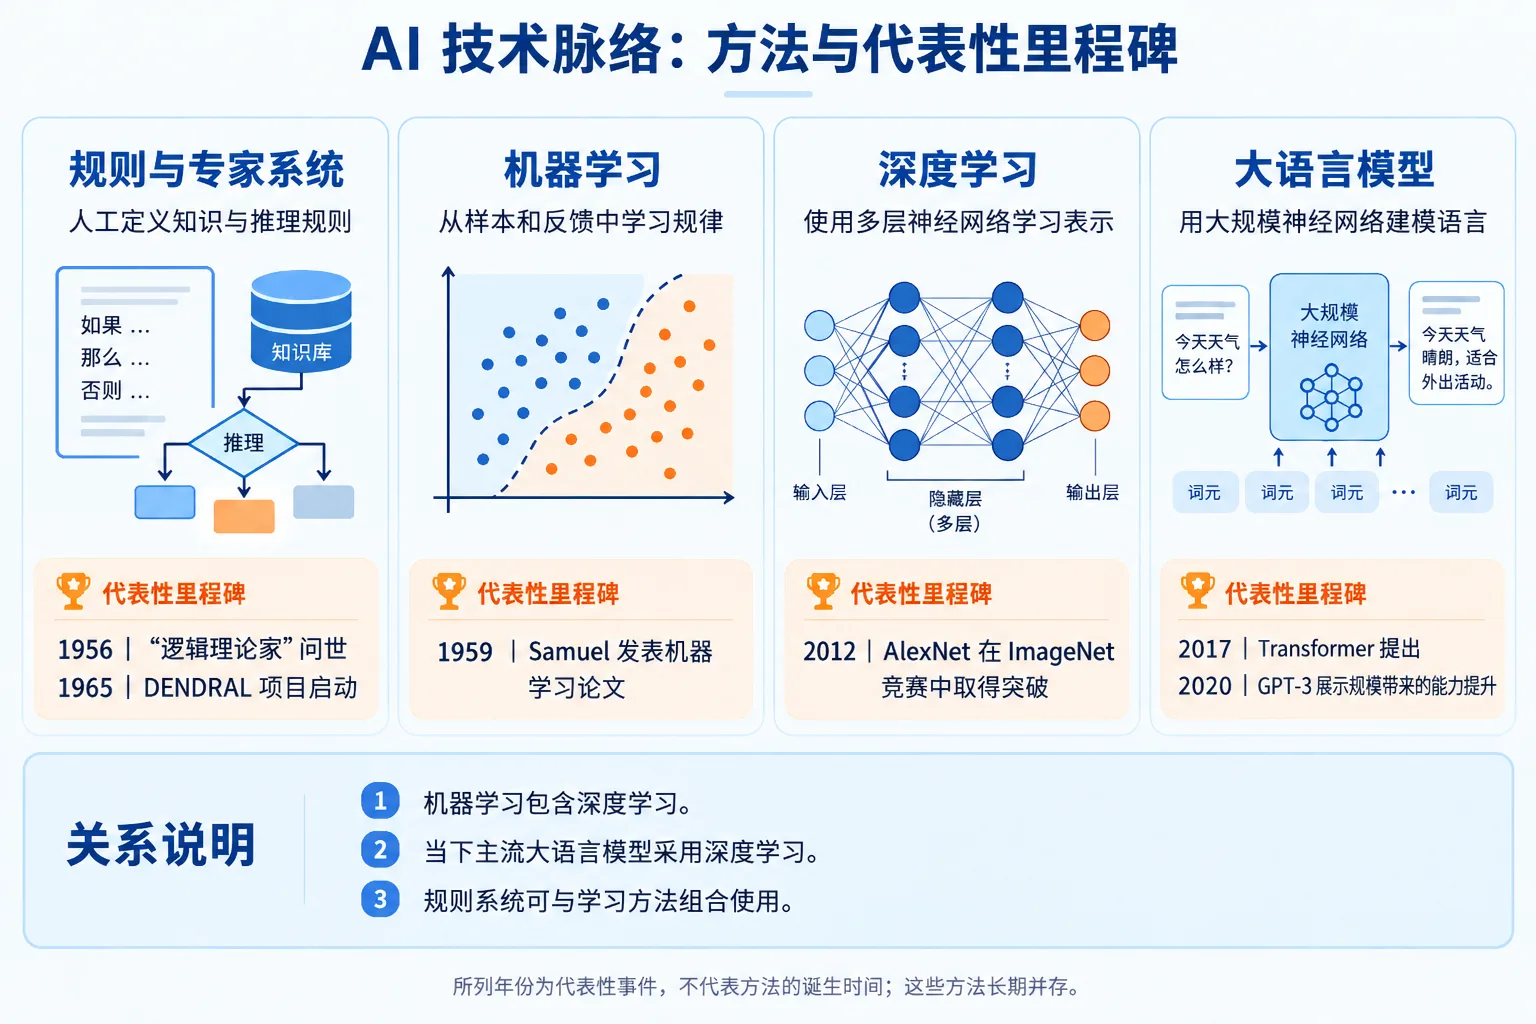
先把关系摆清:深度学习属于机器学习,当下主流大语言模型采用的正是深度学习;写规则的系统今天也还在大量服役,可以与这些方法配合使用。最早是写规则(专家系统):把专家知识一条条录进机器,规则之外一概不会。然后是机器学习:别教答案了,给它看例子,让它自己学个函数出来。
2012 年,AlexNet 在 ImageNet 图像识别竞赛中大幅甩开对手,让深度学习——用多层神经网络的机器学习——一战成名:相比大量手工设计特征,多层网络能从数据中学出更有效的表示,当然,数据、网络结构和训练方法依然样样要紧。
再到大语言模型:2017 年 Google 那篇《Attention Is All You Need》提出 Transformer 架构,2020 年的规模定律研究又发现,语言建模的误差会随参数量、数据量和训练计算量呈现相当稳定的经验规律——“大力出奇迹”从玄学变成了可计算的工程决策,1750 亿参数的 GPT-3 就是这份底气的展示品。
2022 年 11 月 30 日,ChatGPT 上线,五天内注册用户破百万;据 UBS 基于 Similarweb 数据的估算,到 2023 年 1 月,月活跃用户已约达一亿。这里又是一个容易踩的坑:ChatGPT 不是模型——从早期的 GPT-3.5、GPT-4o,到如今的 GPT-6 Astra、GPT-6.1 Sol,这些才是模型,ChatGPT 是 OpenAI 给模型套上的对话产品。发动机不等于汽车,就是这个区别。

那模型的本体到底是什么?一大团参数构成的函数:给它输入,它算出输出。 本文拿大语言模型举例,所以是文本进、文本出;其实模型也能看图、听声——V4.1-Flash 就带原生视觉理解——但“输入是什么”和“能访问什么”,是两个不同的问题。训练让它学会了语言、代码和海量知识,可“学过”不等于“够得着”:你问它“现在几点”,它只能连蒙带猜;让它看看你桌面上那份报告,它连你的桌面在哪儿都够不着——读文件、跑程序,得靠外部系统给它工具和权限。
聪明,但没有手。这个伏笔,下一节收。
Agent:从听懂指令到自主推进任务
做个小实验:对着小爱同学、天猫精灵这类主要依靠预设技能工作的传统智能音箱说——“帮我把这个月的账单整理成表格,发给老婆。”它大概率会答非所问,或者给你放一首《老婆最大》。

音箱能“听懂指令”和“执行技能”,但账单这个任务它接不住。按最宽的定义,它也算 agent——能感知环境,也能对环境产生作用。不过本文要聊的,是由大模型自主推进任务的那种 Agent:判断关键在于,下一步是模型自己根据反馈决定的,还是预设流程安排好的。如果一个传统音箱只是识别意图、调用预设技能,它就更像一个语音遥控器,还不具备本文讨论的自主任务执行能力。
Agent 这个词,其实比大模型老得多。它来自拉丁语 agere,“去做”。1995 年 Russell 和 Norvig 的经典教材里给过定义:能感知环境、并能对环境产生作用的,都是 agent。强化学习领域更是把“agent–环境循环”用了几十年:agent 观察状态、做出动作、环境给反馈,循环往复——AlphaGo 就是在这个循环里练出来的。
大模型登场后,戏剧性的一幕出现了:模型自己会“说”了,但依然不会“做”。一种自然的做法,是让模型也进入“观察—行动—反馈”的循环:给它工具,让它根据执行结果决定下一步——这样的执行循环,并不要求模型在运行时继续学习。沿着这个思路,几年里接连出现了几块里程碑:
- 2022 年 10 月,ReAct 论文让模型“想一步、动一步”:推理和行动交替进行;
- 2023 年 2 月,Toolformer 展示模型能在训练中学会自己插 API 调用;
- 2023 年春天,AutoGPT 让“模型自行拆解目标、调用工具、反复尝试”的演示火遍全网。但演示离可靠交付还有距离:目标可能迟迟无法完成,连续调用又会不断产生费用——项目早期文档也明确提醒,它仍是实验,运行成本需要监控。热闹散场,所有人记住的是同一件事:光有模型和工具还不够,缺的是工程。
- 2023 年 6 月,OpenAI 把 function calling 做成 API 标准能力,从此“模型报工具名和参数,程序负责执行”成了通用模式。

这个循环写出来就这么几行:
while (目标未完成) {
    思考   = 模型(目标, 历史记录, 工具返回值)
    行动   = 选择一个工具(思考)
    返回值 = 执行工具(行动)
    历史记录 += [思考, 行动, 返回值]
}
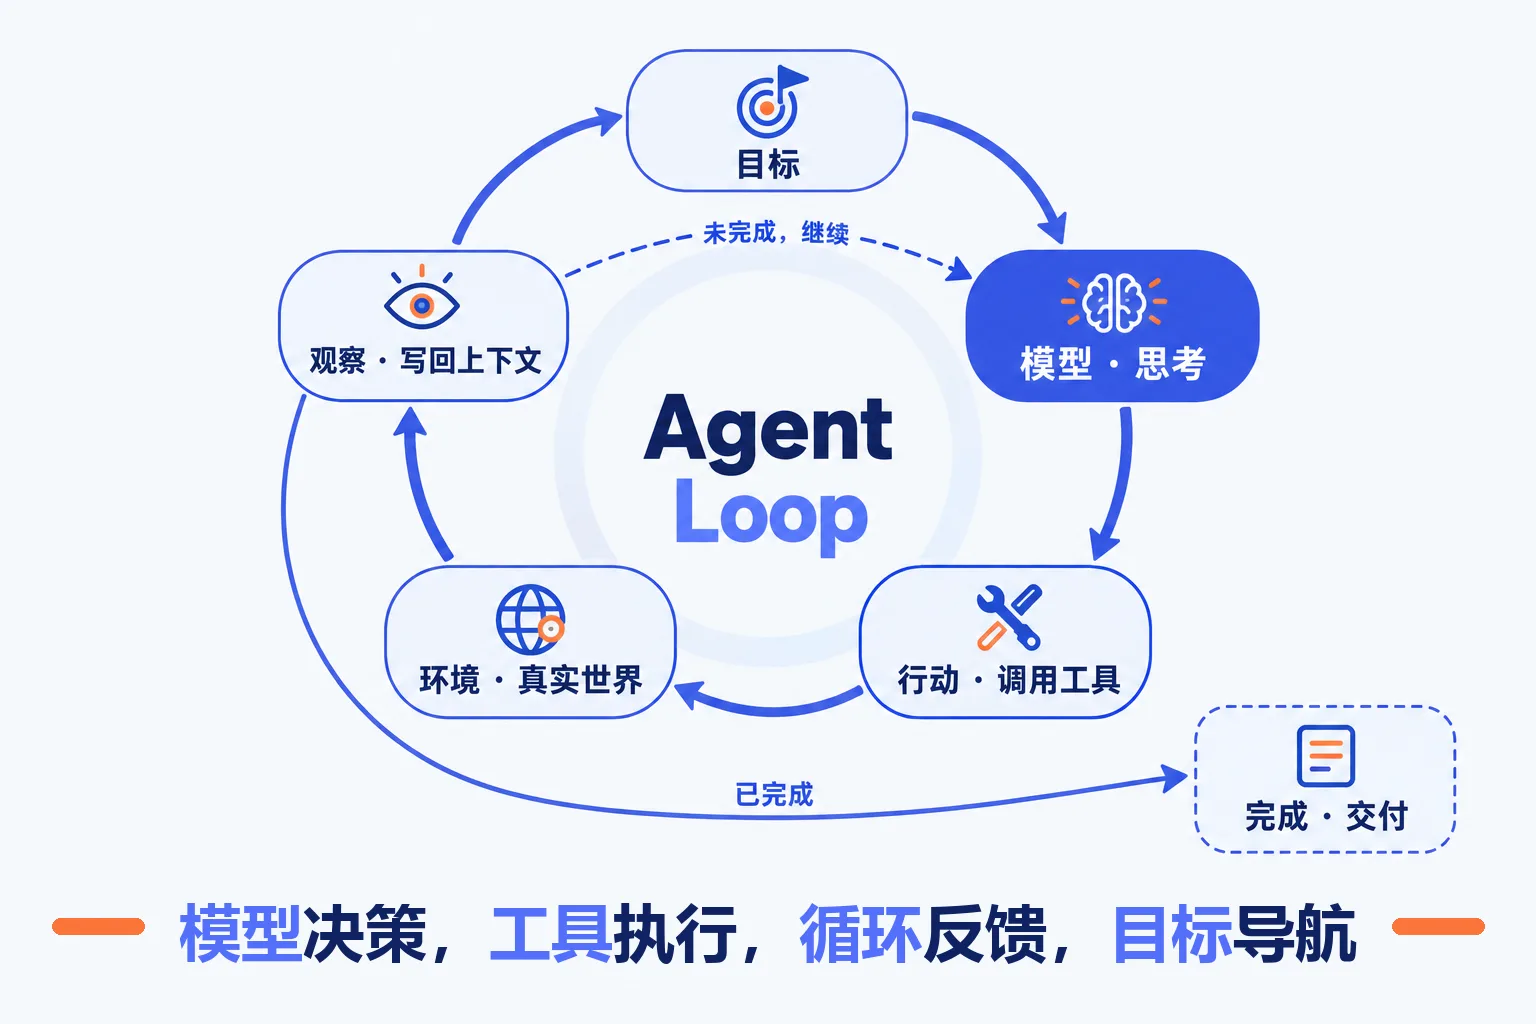
同一个模型,装不装进这个循环,体验天差地别。还拿 DeepSeek 举例:只在官网聊天、没有开放本地访问权限时,它不能主动浏览你的代码目录;接入具备文件和终端工具的编码 Agent 后,它才可以在授权范围内读取代码、修改文件、运行测试。模型没换,换的是它有没有被装进那个自己决定下一步的循环。
2024 年底,Anthropic 在《Building effective agents》里给过一组至今被反复引用的辨析:workflow 由预先设计的代码路径编排模型和工具——路径可以带条件分支,但走向是人事先铺好的;agent 则让模型自己动态决定处理过程和工具使用。他们的建议也很实在:从最简单的方案起步,许多应用用一次配合检索和示例的模型调用就够,需要更多步骤时再考虑 workflow 或 agent。
记住这一句:本文说的大模型 Agent,是由模型自主决定下一步、借助工具并根据反馈持续推进目标的系统。模型负责决策,工具负责执行,循环负责带回反馈,目标负责指方向;要不要停,还得结合验收结果、预算和人工控制来判断。
Harness:同一只 DeepSeek,为什么处处不一样?
终于可以正面回答“DeepSeek 和 Harness 是什么关系”了。
R1 和 2026 年 10 月 17 日更新的 V4.1-Flash-1017 都开放了模型权重,谁都能下载部署。于是同一只模型,活在了好几套完全不同的“装备”里:
- 在官网或 App 里聊:背后是深度求索官方做的对话系统;
- 用 Ollama 把它拉到本地,再套个 Open WebUI:这套界面、参数和配置,就是你亲手搭的;
- 把它的 API 接进 Codex、OpenCode、ZCode 这类编码工具:它又成了别人家 agent 里的引擎。

模型是同一只,体验天差地别。不过先打个补丁:官网、本地部署和 API 用的未必是同一个版本、同一种量化精度,比较前先确认引擎是不是同一台。在把模型配置对齐之后,外围系统给的提示词、工具、上下文管理和权限,仍然会明显改变体验。这层包在模型外面、决定它怎么干活的东西,就是 Harness(马具)。Harness 是模型权重之外、组织模型运行的那部分系统;它可以由深度求索官方提供,也可以由第三方开发。
这个词不是哪份标准文件钦定的,而是社区里叫开的习惯:在模型评测中,EleutherAI 的 lm-evaluation-harness 就用它指代统一组织评测任务、对接不同模型的框架,同一套框架套在不同模型外面跑分;编码智能体兴起后,“agent harness”也成了常见说法。本文用它指:包住模型、支撑它持续执行任务的工具、上下文管理与运行控制机制。
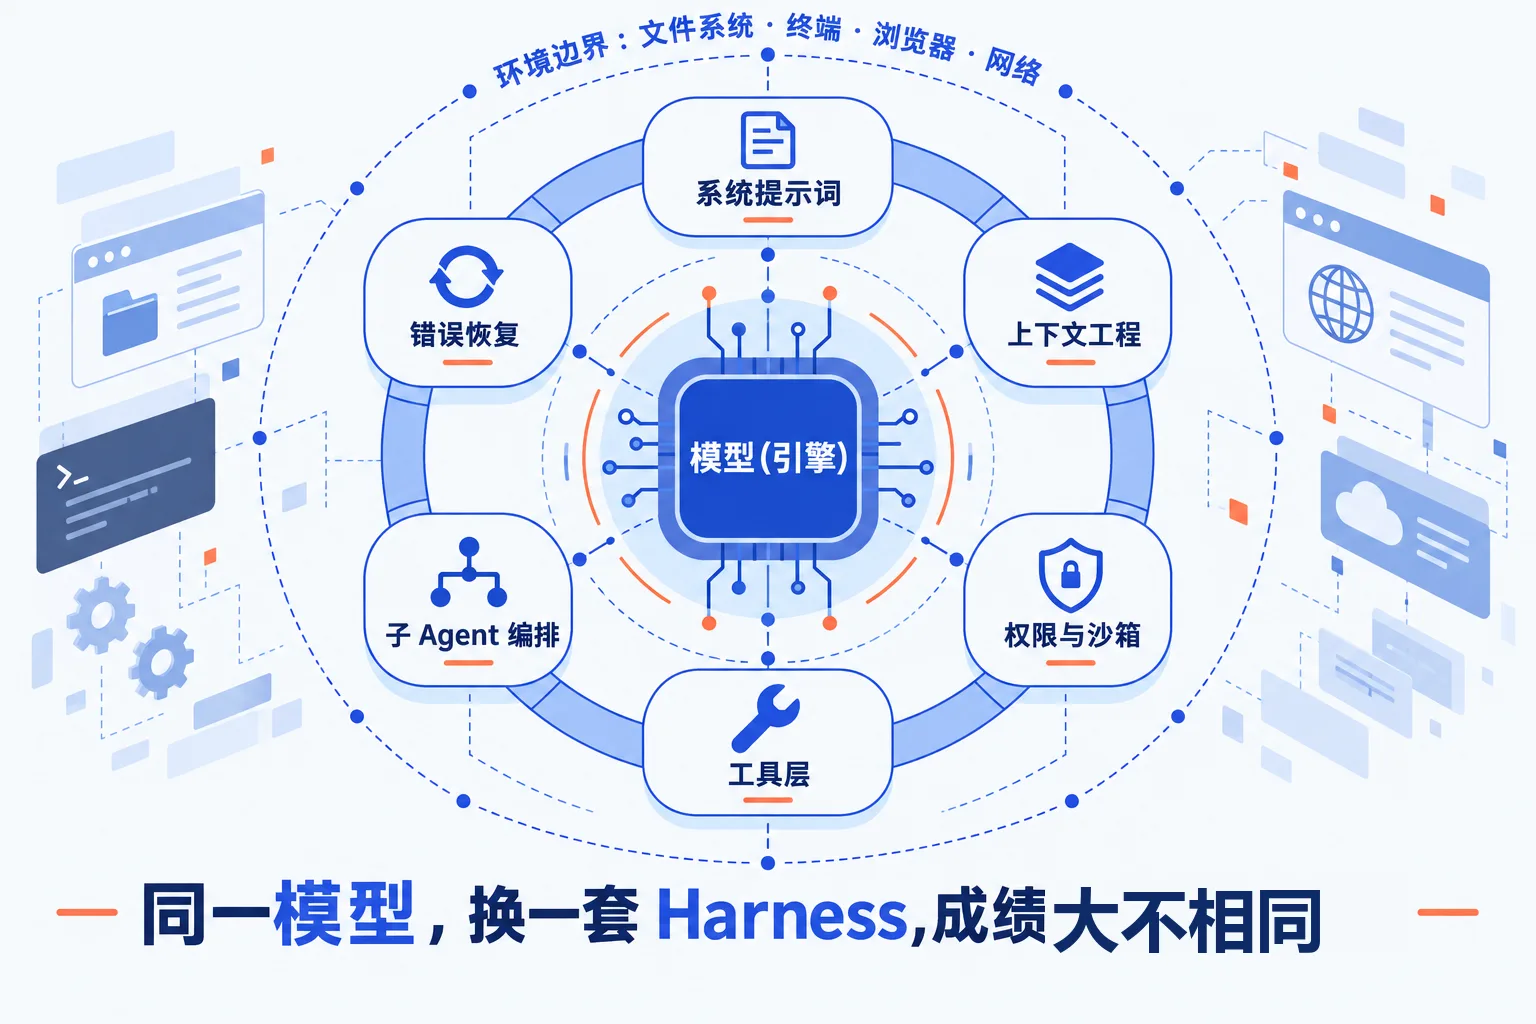
一个编码 agent 的 harness 里大致装着:系统提示词(角色、规范、安全边界)、工具层(读写文件、跑命令、搜索)、主循环(结果回填、决定下一步)、上下文工程(历史裁剪、摘要、记忆文件)、权限与沙箱(什么自动做、什么先问人)、子 Agent 编排(把大任务分给小 agent)、错误恢复(重试、中断、回滚),还有记录与评测(轨迹、成本、回放)。每一项单拎出来都不性感,合在一起却决定了“同一个模型能不能真的干活”。
为什么这么说?因为同一个模型,换一套 harness、换一档预算,成绩可能明显不同。SWE-bench 这类编程榜单上的分数,从来不是模型一个人的成绩,而是“模型 + harness”这个组合的成绩。以后看榜,记得多问一句:用的是哪个模型版本、哪份任务子集、哪套 harness、给了一次还是五十次尝试机会——单个总分,拆不出模型与工程各占几成。
类比还是那辆车:模型是发动机,harness 像传动、转向和控制系统——发动机提供动力,harness 把动力组织成可控的行动,光有发动机,车哪儿也去不了。2025 年 9 月,Anthropic 把支撑 Claude Code 的工具与运行机制打包成 Claude Agent SDK(由 Claude Code SDK 更名而来)提供给开发者,用来搭各种类型的 Agent——发动机大厂开始把成套的传动系统交给开发者自装,这大概是 harness 重要性的最好注脚。
记住这一句:模型提供动力,Harness 把动力组织成可控的行动。换一套 Harness,同一台发动机跑出的是两种人生。
四个词,各自归位
| 概念 | 本质 | 一眼认出它 |
|---|---|---|
| AI | 一门学科,研究“让机器表现出智能” | 达特茅斯会议、AI 寒冬、AlphaGo |
| 模型 | 通过训练获得能力的计算模型,本文主要讨论大语言模型 | GPT-6.1 Sol、DeepSeek-V4.1-Flash、Qwen |
| Agent | 模型自主决定下一步,配工具、循环、目标 | Claude Code、接了工具的 DeepSeek |
| Harness | 包住模型的工具、上下文与运行控制机制 | Claude Agent SDK;Codex 中的工具、上下文管理与执行控制机制 |

现在再把“DeepSeek”这个词掰开:深度求索是公司(在 AI 行业里);R1 是模型(给它输入,它生成输出);官方 App 是产品(模型套了一层官方 harness);而把 V4.1-Flash 接入 Codex、配上工具与自主执行循环,得到的则是一套 Agent 系统(模型自主决策 + 工具 + 循环)。下次再用这个词,你知道自己在说哪一层。
顺手把几个邻居也分清楚:聊天、代码补全、自主执行,是几种不同的交互方式,同一个产品可以同时具备几种——ChatGPT 和 GitHub Copilot 现在都带上了 Agent 功能,Claude Code、Codex 则把 Agent 式的任务执行当成核心体验。判断一个产品属于哪类,看它的活儿是怎么跑起来的,比看名字可靠。
写在最后
把这四个词分清,不只是聊天时不被术语绕晕。下次看到一个 AI 产品,可以依次问三个问题:它用的是什么模型?下一步由谁决定?外围系统提供了哪些工具和运行保障?四个词的区别,就会落到具体行为上。
下一篇顺着 Harness 往下挖:Skills、MCP、hooks、插件、子智能体、指令……这些名词分别对应 harness 里的哪一层,以及怎么用起来。
最后照例说句题外话:这篇从大纲、配图到成文,是一个人、一个模型和一套 harness 协作的产物——写它的 agent,也没能逃出本文的任何一条定义。

七十年大事记
| 年份 | 事件 | 为什么重要 |
|---|---|---|
| 1950 | 图灵测试 | 用文字对话中的辨别任务,替代对“思考”的抽象争论 |
| 1956 | 达特茅斯会议 | 通常被视为 AI 作为独立研究领域诞生的标志 |
| 1966 | ELIZA | 第一个聊天程序,也留下“ELIZA 效应”这个警示 |
| 1974–1993 | 两次 AI 寒冬 | 牛皮与兑现的落差周期,此后反复上演 |
| 1997 | 深蓝胜卡斯帕罗夫 | “人写规则”思路的巅峰 |
| 2012 | AlexNet | 深度学习进入主线视野 |
| 2016 | AlphaGo 胜李世石 | “从数据里学”思路的标志性胜利 |
| 2017 | Transformer | 成为此后大多数主流大语言模型的架构基础 |
| 2020 | GPT-3 与规模定律 | “大力出奇迹”有了可计算的经验依据 |
| 2022 | ChatGPT / ReAct | 模型被大众直接使用;agent 循环挂上大模型 |
| 2023 | AutoGPT / function calling | Agent 出圈也暴露工程短板;工具调用标准化 |
| 2024 | MCP / 《Building effective agents》 | 工具接入有了开放协议;agent 方法论成形 |
| 2025.1 | DeepSeek-R1 发布并开放权重 | 推动开放模型进入更广泛的大众讨论,也凸显公司、模型与产品名称混用的问题 |
| 2025 | 编码 Agent 与 Agent SDK | Harness 产品化,agent 进入日常工作 |
延伸阅读
以下列出本文关键论述的原始出处,方便继续阅读与核查:
- 图灵,《Computing Machinery and Intelligence》(1950):doi.org/10.1093/mind/LIX.236.433
- 麦卡锡等,达特茅斯项目提案(1955):dl.acm.org/doi/10.1145/365866.365868
- Russell & Norvig,《Artificial Intelligence: A Modern Approach》(1995):aima.cs.berkeley.edu
- 《Attention Is All You Need》(2017):arxiv.org/abs/1706.03762
- 规模定律,《Scaling Laws for Neural Language Models》(2020):arxiv.org/abs/2001.08361
- GPT-3,《Language Models are Few-Shot Learners》(2020):arxiv.org/abs/2005.14165
- ReAct,《ReAct: Synergizing Reasoning and Acting in Language Models》(2022):arxiv.org/abs/2210.03629
- Toolformer,《Toolformer: Language Models Can Teach Themselves to Use Tools》(2023):arxiv.org/abs/2302.04761
- DeepSeek,《DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning》(2025):arxiv.org/abs/2501.12948
- Anthropic,《Building effective agents》(2024):anthropic.com/engineering/building-effective-agents
- Anthropic,《Building agents with the Claude Agent SDK》(2025):anthropic.com/engineering/building-agents-with-the-claude-agent-sdk
- MCP 官方文档:modelcontextprotocol.io
- EleutherAI,lm-evaluation-harness:github.com/EleutherAI/lm-evaluation-harness