你只是想修个 bug,菜单却比外卖还长
你只是想修一个 bug,模型菜单却比外卖菜单还长:便宜的怕做不好,贵的又舍不得一直开。更麻烦的是,同一个模型换一只外壳,成绩和账单还会变。这篇先回答一个实用问题:你手里的这件活,该派谁去?
这个秋天几乎每周都有模型发布或更新:从 9 月 21 日到 10 月 27 日,六家公司先后交出七款新一代主力模型——Grok 4.7、Opus 5.5、GPT-6.1 Sol、Gemini 4 Argon、MiniMax M3.1 Flash、Kimi K3.1 Pro、GPT-6.1 Terra,往前再挪几周,GLM-5.3 和 GLM-5.3-Flash 刚完成换代,完整时间线放在文末。先别急着认全名字,菜单只会越变越长;更要紧的是另一件事:就算你不直接调用 API,也在被影响——你用的编程助手、写作工具、搜索摘要,底层多半就是这些名字。

先给全文的核心判断:这个市场没有全能冠军。选模型是按任务匹配,不是追榜单第一;看任何“最强”的说法,都要带上三要素——版本、harness、日期。
丑话说在前面:本文信息截至 2026 年 10 月 27 日。这个行当的迭代以周计,等你读到这篇文章,格局可能又变了一轮;文中所有价格、上下文长度、榜单成绩的具体数字,动手选型前请以官方页面为准。还要交代方法:这篇依据公开文档和评测整理候选,没有把所有模型放进同一套任务里实测——所以下文会区分规格、厂商自测、第三方评测和我的选择建议,最后怎么排班,还要用你自己的任务试一次。完整发布时间线放在文末资料区,按日期排好,方便对表。
下面按顺序讲:先分清两类“模型”,再速览牌桌上都有谁,然后按擅长领域横着比、按价格竖着选,最后给一张选型地图。动笔前先给自己的活儿对个号,带着后两列的问题往下读:
| 手里的活 | 先检查什么 | 试跑时记录什么 |
|---|---|---|
| 修一个能复现的 bug | 能否读到相关文件、执行测试、遵守改动范围 | 是否修复原问题、有没有回归、耗时与总费用 |
| 读长文档并给出结论 | 上下文余量、关键内容能否被找到、引用能否核对 | 漏项、引用准确性、输出是否完整 |
| 写一篇符合自己语气的稿子 | 事实要求、样稿、语气与禁用写法 | 达到可用稿的修改轮数、是否丢约束 |
| 画中文信息图 | 实际底座、编辑能力、标签数量 | 逐字准确、布局可读、修改成本 |
先分清两类“模型”
上一篇《AI、模型、Agent、Harness》里说过:模型是一大团参数构成的函数,给它输入,它算出输出。今天讲选型,为了按任务挑人,本文先按任务把手头的模型分成两组——这不是互斥的技术家谱,同一个产品也可能同时提供两组能力。

一族是语言与多模态理解模型:聊天、写代码、读文档、做分析,以文本进出为主,顺带能看图。GPT 系、Claude 系、Gemini 系、DeepSeek、Qwen、GLM、Kimi,都是这一族。
另一族是图像生成模型:你描述画面,它产出图片。Google 的 Nano Banana、OpenAI 的 GPT Images、字节的 Seedream、Midjourney,是这一族。
严格说,牌桌边还坐着第三族人——音频与视频生成模型:你给一段描述或一首歌词,它产出配音、歌曲或一段视频。这一族 2026 年也挤满了人,OpenAI 的 Sora 2、Google 的 Veo 3.1、快手的可灵 Kling 3.0、字节的 Seedance 系列都是第三方横评里的常客。它们的选型逻辑又自成一派——看时长、分辨率、物理一致性、素材版权,跟聊天、画图都不挨着。本文聚焦前两族,音视频不展开。
有人会问:多模态理解模型不也能“看图”吗,跟画图的什么关系?一句话:看图是理解,画图是生成——一个把图读成字,一个把字变成图,方向相反,是两拨能力。本文说的画图,特指后者。
两族的选型逻辑完全不同:前者看上下文窗口、输出上限、编程与推理;后者看画面质量、文字渲染、风格控制。混在一起横评只会各说各话,所以本文分开讲——接下来两节讲第一族,画图的单独放一节。
能聊会写是一族,会画是另一族,选型前先分家。
家族速览:牌桌上都有谁
先竖着看牌子。表格里只写型号全称和已核实的日期——这个习惯本身,就是本文想教的东西之一。
先交代一个读表的前提。一个家族下面往往不止一个型号,一个型号下面还可能分档:Anthropic 一家就有 Opus、Sonnet、Haiku 三个档位,大致对应攻坚、均衡、速度;OpenAI 在 Astra 之下另设了更便宜的 Sol。上一篇说过,公司、模型、产品是三层东西;到选型这一步,还得再多认一层“档位”——同一家公司里高低档的差距,未必小于两家公司之间。
| 家族 | 本文主要候选(全称) | 最近动作 | 开放权重 | 一句话定位 |
|---|---|---|---|---|
| OpenAI | GPT-6 Astra(同门有 GPT-6.1 Sol、GPT-6.1 Terra) | Astra 2026-09-03 官宣;Sol 2026-09-29;Terra 发布——官方 API 日志记为 10-26,国内快讯见于 10-27(API 型号页已上线,产品端逐步推出) | 否 | Astra 是最强旗舰:计算机操作、编程、专业工作;Sol 官方称“接近 Astra 的智能、五分之一的价格”;Terra 官方定位是视觉推理、精准电脑操作与自然写作的快速高效模型;GPT-6 Luna 在 API 中收费,免费日常用法指产品套餐中的可用档位 |
| Anthropic | Claude Opus 5.5(Sonnet 5.5、Haiku 5.5 同季补齐) | Opus 2026-09-22 | 否 | 旗舰主力;更高档的 Fable 线(2026-06-09 发布)主打大型编程项目与多日自主任务 |
| Gemini 4 Argon | 2026-10-13 GA(9 月底起早享,体验计划口径) | 否 | 新旗舰;1M 统一上下文窗口,默认同步输出上限 65,536 | |
| DeepSeek | DeepSeek-V4.1-Flash-1017 | V4.1-Flash 2026-09-10 首发,1017 为 2026-10-17 更新 | 是(MIT) | 552B MoE;1M 上下文、384K 输出;默认思考、原生视觉 |
| 阿里 Qwen | Qwen3.8-2.4T-A95B(开放权重);托管版 Qwen3.8-Max | 权重 2026 年 8 月开放;托管版功能另行扩展 | 是(Qwen3.8-2.4T-A95B 用 Qwen3.8-Max License,自有许可) | Max 级权重首次开放;托管版基于它另提供视觉输入、非思考模式与内置工具 |
| 智谱 GLM | GLM-5.3(另有 GLM-5.3-Flash) | 2026-08-14;Flash 2026-08-26 | 是(GLM-5.3 License;Flash 为 MIT) | 开放权重编程旗舰;Flash 档是系列首个原生多模态 |
| 月之暗面 Kimi | Kimi K3.1 Pro(上代 K3) | K3.1 Pro 2026-10-24 发布、另有 Highspeed 高速版;权重官方承诺 11-04 前开放 | K3 是(Kimi K3 License);K3.1 Pro 待开放、许可未公布 | 官方称迄今最强,K3.1 系列首个模型;1M 上下文 |
特别标注一下 DeepSeek 那一行:V4.1-Flash 的首发是 2026 年 9 月 10 日(官方发布文),10 月 17 日的 1017 是在此基础上的版本更新——首发和更新是两件事,型号写全才不会张冠李戴。
牌桌边还有几家值得知道的型号:xAI 的 Grok 4.7(9 月 21 日)主打编程与知识工作,带 Expert 模式,Grok 5 尚未发布;Mistral Large 4(10 月 6 日预览)是欧洲选手的旗舰,权重计划 10 月底开放(官方口径“月底”,另有二手报道称 10 月 27 日)——注意还是“计划”;MiniMax 的 M3.1 Flash 10 月 19 日刚落地,走日常高效路线;字节豆包 2.0 今年 2 月发布,定位生产级通用 Agent 模型,还配了专用的编程模型,6 月又更新了 Seed 2.1;Meta 的 Muse Spark 主线闭源驱动着 WhatsApp、Instagram 里的 Meta AI,10 月 15 日又发布了开放权重版 Muse Spark Open——官方称迄今最强的美国开放权重模型,约 816B 参数的 MoE(官方文档口径)、主打编程与 agent 任务,采用自有许可,开放权重不等于开源。

名单之外还坐着不少玩家:美团的 LongCat、阶跃星辰的 Step 5、腾讯混元 4、小米 MiMo 等国产选手(后三家有开放权重版本,聚合站口径),Inception 的 Mercury 3 这类白菜价新秀(首发促销期输入每百万 $0.10,常规价 $0.20,官方口径),Meta 在 10 月 12 日还上线了支持多模态输入、文本输出的 Muse Wonder;另有阿里云提供的 GLM-5.3-Prime、Qwen3.8-Max-Prime 高速服务档,价格更高,主要换取更高的输出吞吐。这些本文不展开——取材以主力档为限,不追求齐全。
这张表里还藏着一个容易被忽略的信息:开放权重的分布。OpenAI、Anthropic、Google 的旗舰全部闭源;DeepSeek、智谱、Kimi 都开放了权重,但许可各有不同——GLM-5.3 用 GLM-5.3 License,GLM-5.3-Flash 是 MIT,Kimi K3 用 Kimi K3 License。Qwen 这边,Max 级权重已以 Qwen3.8-2.4T-A95B 开放,托管版 Qwen3.8-Max 基于它另提供视觉输入、非思考模式与内置工具。需要自行部署、微调或控制推理数据去向的,可以看开放权重型号;但是否省钱,要另算模型规模、硬件利用率、运维与许可——托管 API 的低单价,不能直接换算成同款权重在自己机器上的低成本。能否商用、再分发或拿去做模型服务,要分别核对具体型号的 LICENSE,不能把“开放权重”统称为 MIT;新发布的 Kimi K3.1 Pro,权重官方承诺 11 月 4 日前开放,许可届时才见分晓。
牌桌上没有一家通吃;权重是否开放、许可允许什么,与 API 价格和任务表现要分别比较。
按擅长领域,横着比
家族速览是竖着看牌子,这一节横着看活儿。把常见任务拆成几类,逐类看各家自己怎么说、第三方怎么测。
编程:人人都在讲 agentic coding
为什么各家都抢这个场景?因为编程是目前 agent 落地最深的场景——上一篇讲过,模型配上工具和循环才能真正干活,而写代码恰好是给工具、给反馈都最顺手的活儿:结果能自动跑测试,对错有客观回音。所以看一家模型的最新定位,编程能力是个不错的观察窗口。
逐家过一遍,口径各不相同:
- OpenAI:GPT-6.1 Sol 的官方定位直接写着 agentic 编程与计算机操作;另有第三方评测(SonarSource,2026 年 10 月)称它在这套固定推理档位的 Java 测试题中,功能通过率比 GPT-6 Sol 略有提高——第三方口径、题目集有限,听个参考。
- Anthropic:Opus 5.5 是旗舰主力;更高档的 Fable 线(官方发布文)主打大型编程项目与长时程自主任务——官方举的例子里,一份 5000 万行代码库的全库迁移被压缩到一天完成,早期测试对象包括 Stripe 的 Ruby 代码库。这是官方给出的单一案例,不是对每个项目都适用的承诺。
- Google:Vals AI 在9 月 30 日的更新记录中把 Gemini 4 Argon 列为当时 Vals 综合指数第一——该指数覆盖金融、编程、法律等多类知识工作,不限于编程;软件工程基准 DeepSWE v1.1 的成绩则是 Google 的自测报告。两项的任务、来源和比较设置不同,拼不成统一的编程排名。
- 智谱:GLM-5 系列的副标题就叫 “From Vibe Coding to Agentic Engineering”;GLM-5.3 官方称是开放权重中最强编程(官方口径,出自自家基准)。
- DeepSeek:V4.1-Flash-1017 官方称推理、编程、Agent、视觉全面升级,且已官方适配 Codex——后面讲混用时展开。
- Kimi:K3 被媒体口径定位为“长程编码与知识工作”。
六家都说自己行,那到底谁最强?这个问题本身就问错了——先别急着排座次,先学会看口径。
看榜之前,先看口径
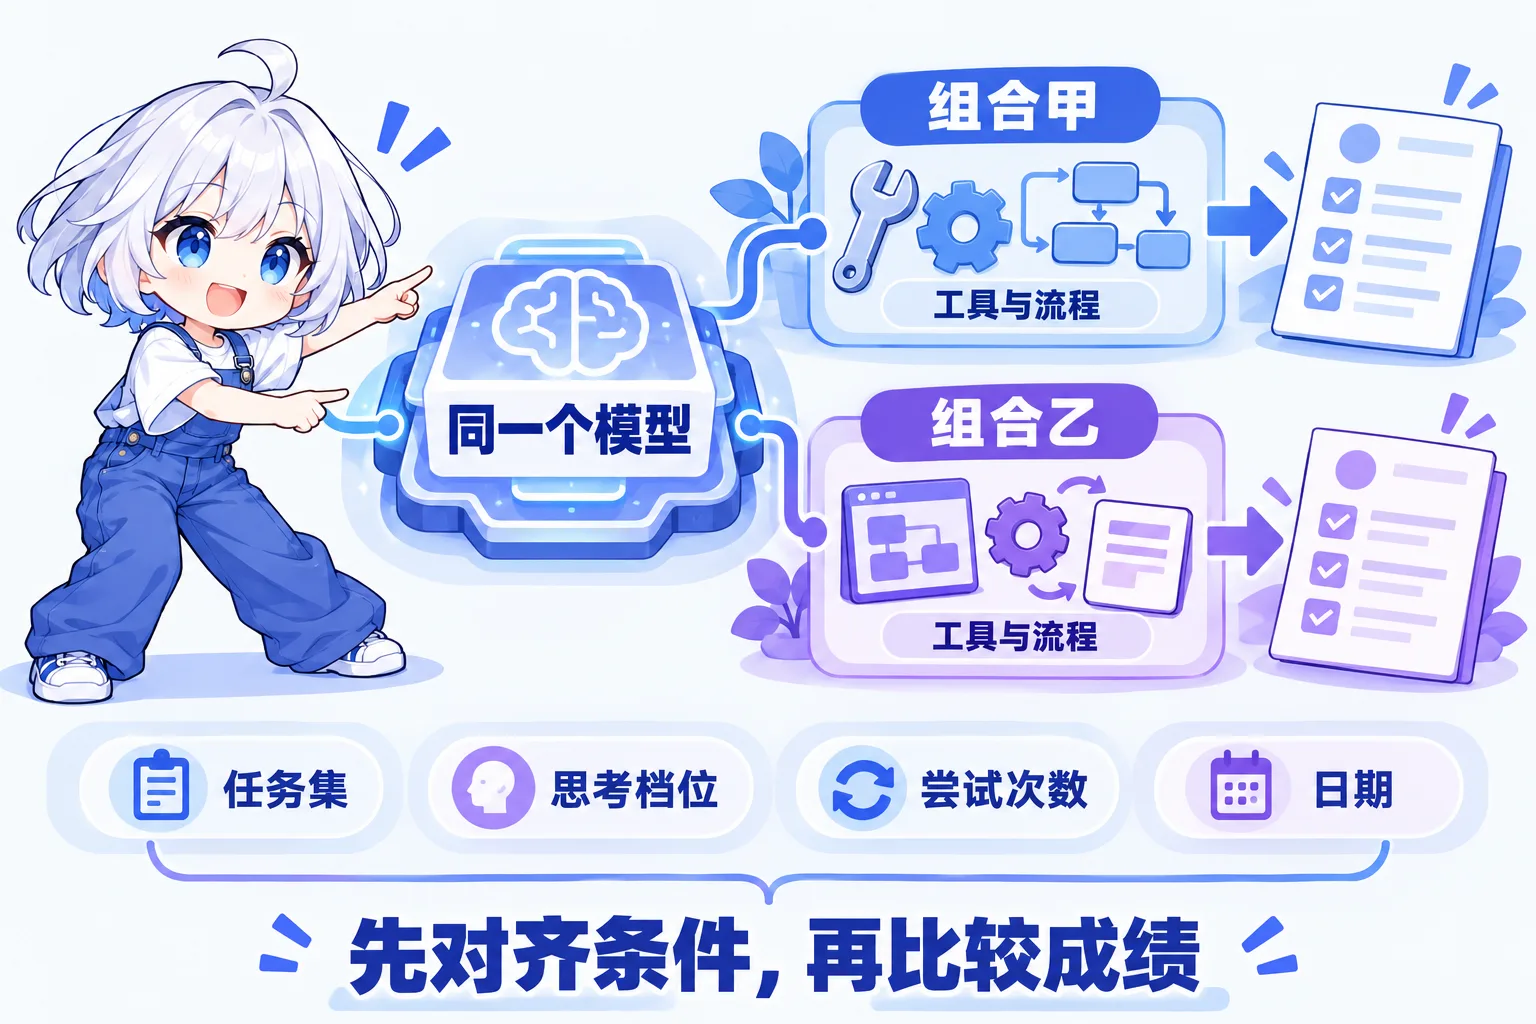
先解释两个词。harness 上一篇已经讲过:包住模型、组织它运行的工具与控制机制;scaffold 是评测圈的习惯说法,意思接近——跑分时套在模型外面的那层脚手架,负责把题目喂进去、把答案收上来。同一道题,喂法不一样,成绩就不一样。
拿最常用的 SWE-bench Verified 举例。Verified 是 500 条人工筛选的任务子集,这是基准本身的定义;官网默认展示的 Bash Only 视图,统一用 mini-SWE-agent 这个极简 harness 运行;Epoch AI 的基准页则采用自己的 scaffold(工具不止 bash,还有 text_editor、apply_patch),并注明实际采用经基础设施验证的 484 题子集。同一个基准名字下,运行设置可以各不相同——换句话说,这份榜单上的分数从来不是模型一个人的成绩,而是“模型加 harness”的组合成绩,上一篇讲过的道理,官方榜单自己先做了示范。引用时,把基准名称和实际运行设置一起记下来。
为什么必须核对 harness?有第三方研究系统整理过 80 种方案:这份分析汇总的是各方案的榜单提交、模型组合与采用的架构(摘要页),跨系统的差异不能全部归到模型本身——你看到的两份成绩差,差的可能是工具、流程和模型组合。比较两份成绩时,先确认模型版本、任务集、尝试次数和 harness 是否一致;变量没对齐,就不要把分差当作模型进步。
LMArena(榜单页)这类聚合站更得小心。Arena 也要先认子榜:聊天偏好榜和 Agent 榜的题目与评分方法不同(官方方法说明只覆盖成对偏好榜),不能只看网站名字就当作同一份成绩;其他网站还可能转展示 Arena 的历史数据,并不是另一套独立测评。引用时请写明子榜、具体日期和完整模型配置;没有取得可对齐的快照,本文就不报谁排第一。
上一篇留过“看榜四问”:哪个模型版本、哪份任务子集、哪套 harness、给几次尝试机会。这一节再补一条引用纪律:引用先认版本、运行配置和日期,缺一项,分数的参考价值就要打折扣;要比较强弱,还得再核对任务集、指标和尝试预算。
任何分数都是“版本、harness、日期”三个人的合影;要比较强弱,还得核对任务集、指标和尝试预算。
长文本:窗口大不等于输出长
“长文本”其实是三件事:上下文窗口总共多大(输入、思考、输出共用这一容量);单次生成上限,一次调用最多能用多少生成 token;以及接口支不支持分段续接。读长文档看窗口,写长文档看生成上限,能不能写超长还要看续接,是几回事。
上下文窗口这一项,已核实口径里 Gemini 4 Argon 是 1M,DeepSeek V4.1-Flash 是 1M,Kimi K3 与接棒的 K3.1 Pro 官方文档同为 1M,Claude Opus 5.5 在 API 及付费 Claude 聊天中均提供 1M,新发布的 GPT-6.1 Terra 是 1,050,000,具体仍需核对入口和套餐。单看这几家,1M 已经是旗舰档的常见配置。注意 1,048,576 这个精确数字出自 Gemini 4 Argon 的文档:窗口由输入、思考和输出共同占用,不是可以同时塞满 1M 输入再吐出 1M 输出——各家的占窗规则以各自文档为准。

单次生成上限的差异就大了:Gemini 4 Argon 的默认同步输出上限是 65,536(即 64K)tokens;需要更长结果时可用 long decode,通过后台执行或客户端续接分段推进,上限还要扣除输入等已占用的窗口。DeepSeek V4.1-Flash 是 384K;Opus 5.5 约 128K。
这些数字不能直接换成正文长度:不少思考接口的生成预算包含思考和最终回答——以 Claude 和 Gemini 为例,思考也占生成预算。除了估算目标正文,还要给思考留余量,并核对本次请求实际设置的生成上限。同样是“把这份两百页的报告压缩成五万字”,先估算目标输出大概多少 token,再对照上限——上限够大也只是必要条件,能不能按要求写满、写得好,还得实际试。
还有一笔账容易漏:窗口和输出是要花钱的。截至 2026 年 10 月 20 日,Gemini 4 Argon 的标准促销价是每百万输入/输出 $2/$10,持续到 11 月 30 日,12 月 1 日起恢复 $4/$20。OpenAI 这边,GPT-6 Astra 与 GPT-6.1 Sol 在输入超过 272K tokens 时,对整次请求的输入及缓存费率乘 2、输出费率乘 1.5。所以“能把整本书塞进去”和“值得把整本书塞进去”是两回事——读长文档之前,先想想这一窗口值多少钱,顺手查一下型号和长度落在哪个计费档。
读长文档看输入窗口,写长文档看单次生成上限——窗口大不等于写得长,长文本还得问一句接不接得上。
写作与中文创作:榜单只能参考,真稿还得自己试
写作这一类得老实说:各家发布会都把“专业写作”“设计判断”挂在嘴边(这是 GPT-6 Astra 官方页的口径),但中文写作的公开评测各有题型、语言范围和评审方法,未必覆盖本文这些新型号,本文不据此排统一名次。

能给你的最实用的一条:拿你真正要发的一篇稿子试——一篇公众号稿、一份技术方案、一封难回的邮件,让候选模型各写一版。核对四件事:事实有没有编,结构是否顺,语气像不像你,修改两轮后会不会把已确认的要求改丢。
再送一套土办法,三步:第一,固定任务,别今天写散文、明天写公文,变量都没了对不上;第二,盲评,把几个模型的输出混在一起,隔天再看,别让品牌印象替你打分;第三,多轮,写一次好不算好,至少来三个回合。固定任务和要求,隐藏模型名,比较达到可用稿所花的修改轮数。这套办法朴素,但比看广告靠谱——照着做,就能回答你的稿子交给谁更省事。
写作榜单帮你缩小候选,你自己的稿件才决定谁合适。
思考档:什么时候开“深度思考”
最后一个横向维度是思考档。各家普遍给模型配了“想得再深一点”的模式:DeepSeek V4.1-Flash 出厂默认思考,但官方 API 留了开关——thinking 参数传 {"type": "disabled"},或把 reasoning_effort 设成 "none",就切到非思考模式;榜单里见过的 Max、High,是具体记录里的配置标签,通常表示参赛的是思考档位,不能仅凭后缀推断所有厂商的含义。

思考档的代价藏在账单和等待里:提高思考强度通常会增加思考 token 消耗和等待时间,可见回答却不一定更长——查实际用量比看回复字数可靠。这也是为什么榜单里带档位后缀的成绩,不能直接和无档成绩比——变量没对齐。
使用策略一句话:难任务提高思考强度,简单任务先调低。能不能整个关掉,各家不一:DeepSeek V4.1-Flash 与新发布的 GPT-6.1 Terra(思考档支持 none)支持切到非思考模式;GPT-6.1 Sol 最低只到 low,Gemini 4 Argon 也只有 low、medium、high 三档——“关”并非通用选项,动手前先核对参数表。架构设计、疑难 bug、长链条推理,值得让它多想一会儿;改错别字、调整格式这类活儿,把档位降下来就够。
思考档是涡轮,难活才踩到底,简单活先降档。
画图:另一族模型
回到前面分出的另一族。2026 年 10 月,图像生成的主力阵容是这几位:
- Google Nano Banana 2.1:10 月 6 日上线,是 Nano Banana 2 的更新版,官方强调视觉质量、文字渲染与多轮一致性;第三方报道(The Decoder)称部分基准超过上代 Pro、价格更低。
- OpenAI GPT Images 2.5:9 月 8 日进入 API 与 ChatGPT(API 侧含 Sunburst、Flare 两个型号,官方型号页口径)。
- 字节 Seedream 5.0 Pro:7 月 8 日发布,官方强调高密度信息图、文字渲染、多语言生成和局部精修——要在海报、封面图里写汉字,它可以进候选名单。它也是即梦可选的底座之一(Seed 官方模型目录在它名下直接提供「前往即梦体验」入口),使用即梦时还要确认当前选的是哪个模型,图里的中文仍需逐字核对。
- Midjourney V8.2:7 月 24 日起为默认生成版本;另有 V8.2 编辑模型于 8 月 27 日开始社区测试,9 月继续迭代 alpha 编辑界面。生成版本与编辑模型的进展要分开看。风格化创作社区仍是它的基本盘。
这些型号都可以进入候选,但文生图、图像编辑、中文信息图和风格化创作要分开试。本文没有同一日期、同一任务和预算下的完整对照,因此不排统一名次;使用即梦等产品时,还要核对当前实际提供的底层型号。顺带一提,本文信息图也是这类模型的活儿:按统一风格生成几版,挑最好的一张,再把图里的中文逐字核对。
画图是另一族模型,别拿对话模型的榜单去挑画图工具。
价格量级:差的是几十倍
横着比完能力,竖着看价格。下表是能核实的 API 牌价,按每百万 token 计费,查询时点除标注外为 2026-10-20;每行都标了来源性质——官方页直出的和第三方转述的,可信度自己掂量:
| 模型 | 输入/输出(每百万 token) | 币种 | 口径与来源 |
|---|---|---|---|
| GPT-6.1 Sol | $2 / $10(缓存输入 $0.10) | 美元 | OpenAI 官方型号页;Standard 档、输入不超过 272K,长上下文与加速档另计 |
| GPT-6.1 Terra | $1 / $5(缓存输入 $0.05) | 美元 | OpenAI 官方型号页;2026-10-27 核对,超过 272K 输入的整请求加价规则与 Sol 相同 |
| Claude Opus 5.5 | $4 / $20 | 美元 | Anthropic 官方型号页;官方称较上代 Opus 5 降约两成 |
| Gemini 4 Argon | 促销期 $2 / $10(至 2026-11-30),之后 $4 / $20 | 美元 | Google 官方定价页 |
| Kimi K3 | $3 / $15(缓存命中 $0.30 起) | 美元 | Kimi 国际站牌价;缓存写入与读取按规则分别计费 |
| Kimi K3.1 Pro | $2 / $10(缓存命中 $0.20) | 美元 | Kimi 国际站牌价,标准版;Highspeed 另价(2026-10-27 核对) |
| DeepSeek V4.1-Flash | 高峰 ¥2 / ¥8,闲时半价(¥1 / ¥4),缓存命中 ¥0.02 到 ¥0.04 | 人民币 | DeepSeek 官方定价页 |
| DeepSeek V4-Pro | 高峰 ¥9 / ¥27,闲时半价 | 人民币 | DeepSeek 官方定价页 |
| Qwen3.8-Max | ¥12 / ¥36(缓存命中 ¥1.5) | 人民币 | 百炼华北 2(北京)标准调用价;地域、Batch、显式缓存另核 |

价格按各自站点和地域列示,人民币与美元未换算;缓存只作用于符合条件的输入,另核写入及保存规则。读表的方法比背数字重要,量级结论有三条:旗舰档的输出价大致落在 $10 到 $50 一档,促销期更低;国产开放线和轻量档把输出价拉低到几美元甚至更低;仅看缓存命中输入这一项,Qwen3.8-Max 北京区每百万 ¥1.5,DeepSeek V4.1-Flash 高峰时段 ¥0.04,牌价相差 37.5 倍——这个倍数只描述缓存命中输入的单价,缓存写入等费用和整项任务的总账,仍要另算。
表里两个词顺带解释一下。缓存命中:同一段反复出现的前文(比如那份写了几百行的系统提示词),再次计费时按缓存价算——以 DeepSeek 为例,缓存命中的输入高峰时段每百万 ¥0.04、闲时 ¥0.02,这个价本身已含峰谷差异,不再额外半价;而且只有实际命中的输入享受缓存价,未命中的输入和输出仍各按自己的单价计费。闲时半价:错开高峰时段使用,未命中的输入与输出价格减半,具体时段以官方定价页为准。上面说的都是每百万 token 的单价,不是你单次任务的账单。
订阅制是另一套账,也值得单独摆一张表(Claude、ChatGPT、Google 按美国区美元月付价,GLM 按官网美元价,Kimi 按国内人民币月付价;2026-10-27 核对,地区定价与税费另核,以官方页为准):
| 订阅 | 月费 | 口径与来源 |
|---|---|---|
| Claude Pro / Max | $20;Max 分 $100、$200 两档 | Anthropic 产品页;订阅含 Claude Code 使用额度 |
| ChatGPT Plus / Pro | $20;Pro 分 $100、$200、$500 三档 | OpenAI 官方定价页;含 Codex 等入口 |
| Google AI Pro / Ultra | $19.99;Ultra $99.99 起 | Google 官方订阅页 |
| GLM Coding Plan | $18 起 | 智谱官方文档;可在 Claude Code、Codex 等外壳内用 |
| Kimi 会员 | ¥49 起,最高档 ¥1,399 | Kimi 官方会员页;月付口径,年付折合更低见官方页 |
| DeepSeek | 无包月订阅 | 官方平台按量充值 |
两套账怎么选,看用量形状:每天稳定用、以聊天和写代码为主的人,订阅的包内额度往往比按 token 划算;用量忽高忽低、或要给程序批量调 API 的,按 token 计费不做无用功。另外,产品内用量与 API 用量分别记账,不能把产品额度直接当成可自由调用的 API 余额——不过部分套餐会另赠 API credits(比如 Anthropic 的 Max 档),领取条件、可用额度和超额计费要单独核对。Claude、ChatGPT、Gemini 的订阅对地区和支付方式另有要求,下单前先核对官方支持范围。
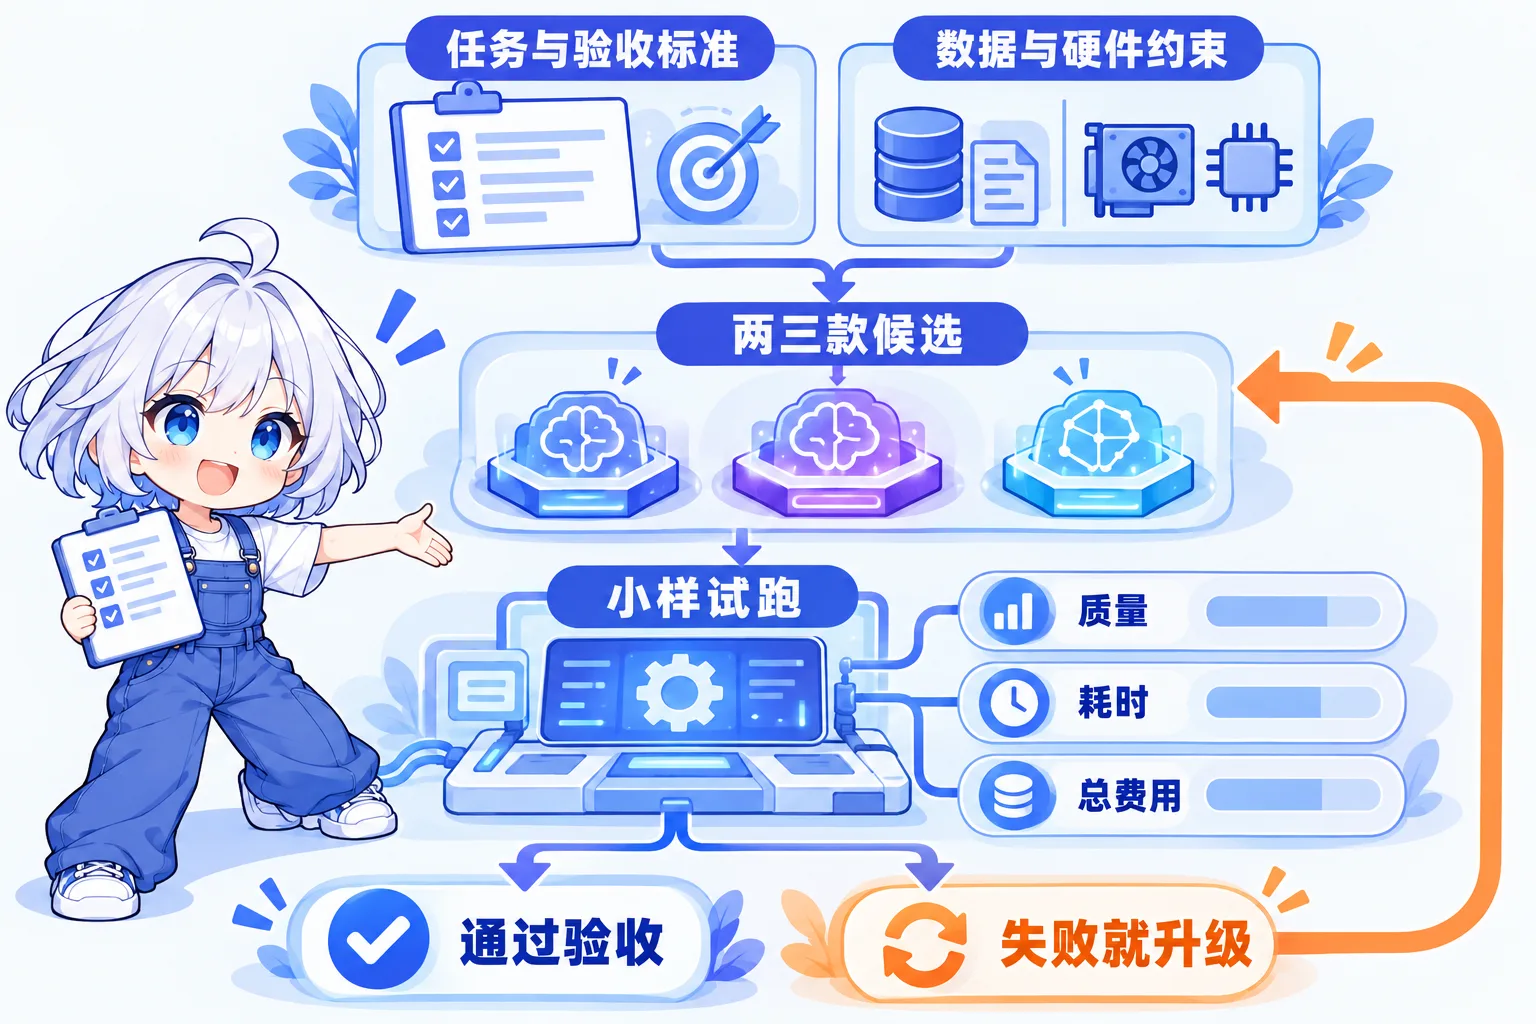
不同档位的 token 单价能差几十倍,但单次任务花多少钱还看上下文、输出量、缓存命中和重试——先拿真实任务试跑一次、记下总费用,再决定长期派谁上。
怎么选:按任务、预算和部署方式筛选
能力横比和价格竖选交叉起来,筛选顺序是这样的:先用任务难度和预算缩小范围,再单独看一眼要不要本地部署——部署方式不是第四个象限,它和预算、难度是两个独立的问题,本地部署也可能极贵、也可能要承担攻坚任务。
先按任务和预算分三档,给出我个人的试跑候选(一家之言,供对照,不是前文已经证明的强弱排序):
- 日常轻活:格式整理、错别字、问答、简单改写——预算敏感就先试 DeepSeek、GLM 的低价档,用自己的任务核对总费用;
- 均衡主力:多数工作场景的中间档,能力和价格的平衡点——Claude Sonnet 5.5、GPT-6.1 Sol 这一档;OpenAI 10 月 27 日新推的 GPT-6.1 Terra($1/$5,官方型号页)也主打这一档位,可列入试跑;
- 旗舰攻坚:架构设计、疑难 bug、长链条推理、大型项目——Opus 5.5、GPT-6 Astra、Gemini 4 Argon、Kimi K3.1 Pro,再请出来。
再决定部署方式,这是另一道选择题:
- 托管服务:省去硬件和运维,产品订阅、API 按量或包内额度各有各的算法,多数人的默认选项;
- 权重自部署:需要在受控环境里自行推理或微调,可以评估 DeepSeek、GLM、Qwen 等开放权重型号;批量任务还需与托管方案比较。成本包括硬件、存储、电力、运维与许可;若调用外部工具,数据流向也要单独核对。
比选定一个模型更进一步的玩法,是多模型混用。多模型使用已经有现成入口,但接入第三方、手动切换和自动分工是三件事,各家能力不同:
- Claude Code:原厂支持围绕 Claude 系模型(直连,外加 Bedrock、Vertex 两条云上通道)。DeepSeek 等服务商也提供官方兼容接口和配置指南,可以通过环境变量接入,无须另装社区切换工具;但这不等于 Anthropic 为这些非 Claude 模型提供支持。Claude 系内部还有个官方功能叫 opusplan:规划阶段用 Opus,方案批准后自动切到 Sonnet 执行——“贵的想、便宜的做”被做成了一个开关。
- Codex:Codex CLI 官方支持配置第三方模型接入。DeepSeek 官方适配 Codex:8 月 13 日的 V4-Pro 正式版公告已明确针对 Codex 适配(公告文),提供 deepseek-flash 与 deepseek-v4-pro 两个模型名,一键配置;截至本文日期,deepseek-flash 对应 V4.1-Flash-1017。
- GLM Coding Plan:智谱的订阅走“借壳”路线:官方订阅页写明,可在 Claude Code、Codex、Cline、OpenCode 这些工具里使用 GLM 模型。
- Cursor:原生聚合 OpenAI、Anthropic、Google、xAI 的前沿模型;也支持自带 API key,但 Tab 补全这类功能不开放 BYOK(官方帮助文档)。

拿一天的工作流举例:早上把需求和约束丢给旗舰档,让它出方案、拆任务——想清楚再动手;白天批量的小修改、格式整理、测试补全,交给便宜档排队跑;晚上复盘,再用旗舰档过一遍关键改动。同样的活儿全用旗舰,账单可能是好几倍;但便宜档接活的前提是边界清楚、结果容易验收——遇到复杂依赖、验收不过或高风险改动,就升级执行或加一道复核。规划换人、执行换人时,把约束、已做决定和验收标准一起交接。排班,就是在两者之间找平衡,是否真省了钱,最后看通过验收的总费用。
这套玩法有句口诀:贵的负责想,便宜的负责做——前提是任务边界清楚、结果能够验收。规划、审题、定方案交给旗舰档;执行、批改、跑腿交给便宜档。
模型不是选一个,是排一个班——按任务排班,按验收升级。
保质期:这篇文章怎么自我校对
再强调一次:本文信息截至 2026 年 10 月 27 日。想核对最新情况,按这个顺序查:先看官方发布页,再看官方定价页,最后才是带三要素的榜单快照。顺序反过来,就容易被二手信息带偏。
举个例子:想确认某个型号的上下文长度,第一手去处是官方 API 文档和发布文,其次才是评测文章——转述文可能引用的是几个月前的旧版,也可能把输入窗口和输出上限抄混。顺手把三要素用在自己身上:三个月后回看本文,请先看日期,再决定信多少。
另外交代一句来源纪律:规格与价格,优先查对应型号、地域和档位的官方文档;厂商自测注明归因,第三方结果注明测试范围,个人建议说明是经验判断。来源冲突先核对日期和条件——很多“打架”只是日期、地域或套餐不同——仍无法解决的数字暂不采用。所以如果发现“某个型号的上下文怎么没提”,多半不是遗漏,是它还在存疑名单上。
写在最后
收个尾。这个秋天的模型市场,没有全能冠军,只有各擅一隅的选手:选模型是按任务和预算匹配,不是追榜单第一;看任何“最强”,先检查版本、harness、日期三要素齐不齐。
模型选好了,下一个问题是装进哪个壳。下一篇《Harness 横评》就聊这个:同一个模型,套上不同的 harness,体验和账单会差成什么样。
写这篇最大的体感不是“谁更强”,而是查价格查到眼花——表里每个数字都得回到官方页重核一遍。修订这版时,月之暗面和 OpenAI 先后在凌晨甩出了 K3.1 Pro 和 GPT-6.1 Terra,文末时间线又得添两行。这个行当,是真不给人喘气的时间。

附录:本文涉及的主要发布时间线
开头说过,这个秋天发布密度极高。把本文点到的事件按日期排开如下(已核实口径,与正文“首发/更新”的区分一致):
| 日期 | 事件 |
|---|---|
| 2026-07-08 | 字节发布 Seedream 5.0 Pro |
| 2026-07-16 | 月之暗面发布 Kimi K3(07-27 开放权重) |
| 2026-08-13 | DeepSeek 官方适配 Codex,提供两个模型名 |
| 2026-08-14 | 智谱发布 GLM-5.3 |
| 2026-08-26 | 智谱发布 GLM-5.3-Flash |
| 2026-09-03 | OpenAI 官宣 GPT-6 Astra |
| 2026-09-08 | OpenAI GPT Images 2.5 进入 API 与 ChatGPT |
| 2026-09-10 | DeepSeek-V4.1-Flash 首发 |
| 2026-09-21 | xAI Grok 4.7 就位 |
| 2026-09-22 | Anthropic 发布 Claude Opus 5.5;同一天 OpenAI 将 GPT-6 Sol、GPT-6 Luna 推进 API 与 Codex |
| 2026-09-28 | Anthropic 发布 Claude Sonnet 5.5 |
| 2026-09-29 | OpenAI 发布 GPT-6.1 Sol |
| 2026-10-06 | Google Nano Banana 2.1 上线;Mistral Large 4 预览 |
| 2026-10-07 | Anthropic 发布 Claude Haiku 5.5 |
| 2026-10-12 | Meta 上线支持多模态输入的 Muse Wonder |
| 2026-10-13 | Gemini 4 Argon 正式 GA |
| 2026-10-15 | Meta 发布开放权重版 Muse Spark Open |
| 2026-10-17 | DeepSeek-V4.1-Flash-1017 版本更新 |
| 2026-10-19 | Inception 公布 Mercury 3 并提供首发促销价;MiniMax 发布 M3.1 Flash |
| 2026-10-24 | 月之暗面发布 Kimi K3.1 Pro 与 Highspeed 高速版 |
| 2026-10-26 | OpenAI 发布 GPT-6.1 Terra(官方 API 日志口径;国内快讯见于 10-27 凌晨,产品端逐步推出) |
延伸阅读
以下列出本文关键信息的出处,官方发布页优先,方便继续阅读与核查:
- OpenAI,GPT-6 Astra 发布页:openai.com/index/gpt-6-astra
- OpenAI,GPT-6 Astra 型号与定价(272K 长上下文档规则):developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI,GPT-6.1 Sol 型号与定价(最低 low 思考档):developers.openai.com/api/docs/models/gpt-6.1-sol
- OpenAI,GPT-6.1 Sol 发布文:openai.com/index/introducing-gpt-6-1-sol
- OpenAI,GPT-6.1 Terra 型号与定价($1/$5、1,050,000 窗口、思考档含 none):developers.openai.com/api/docs/models/gpt-6.1-terra
- 财联社,GPT-6.1 Terra 发布快讯(2026-10-27):cls.cn/detail/2515842
- OpenAI,GPT Images 2.5 发布公告:community.openai.com
- Anthropic,Claude Opus 5.5:anthropic.com/claude-opus-5-5
- Anthropic,Opus 5.5 型号文档:platform.claude.com/docs/en/models/opus-5-5/overview
- Claude 付费套餐上下文窗口说明:support.claude.com/en/articles/8606394
- Anthropic,Max 与 Team 档月度 API credits:support.claude.com/en/articles/17154008
- Anthropic,Claude Haiku 5.5:anthropic.com/claude-haiku-5-5
- Anthropic,Claude Fable 5 与 Mythos 5:anthropic.com/news/claude-fable-5-mythos-5
- Google,Gemini API 更新日志(Gemini 4 Argon GA):ai.google.dev/gemini-api/docs/changelog
- Google,Gemini 4 Argon 型号文档(统一窗口与同步输出上限):ai.google.dev/gemini-api/docs/models/gemini-4-argon
- Google,long decode 使用条件:ai.google.dev/gemini-api/docs/long-decode
- Google,Gemini API 官方定价:ai.google.dev/gemini-api/docs/pricing
- The Decoder,Nano Banana 2.1 报道:the-decoder.com
- Google,Nano Banana 2.1 官方型号页:ai.google.dev/gemini-api/docs/models/gemini-nano-banana-2.1
- SonarSource,GPT-6.1 Sol 编程评测:sonarsource.com/blog/openai-gpt-6-1-sol-evaluation
- xAI,官方新闻页:x.ai/news
- Mistral,Large 4 发布页:mistral.ai/news/mistral-large-4
- ByteDance Seedream 5.0 Pro 官方发布文:seed.bytedance.com/en/blog/beyond-generation-it-understands-design-introducing-seedream-5-0-pro
- ByteDance,Seed 官方模型目录(Seedream 5.0 Pro → 即梦入口):seed.bytedance.com/zh/models
- DeepSeek,V4.1-Flash 发布(2026-09-10):api-docs.deepseek.com/zh-cn/news/news260910
- DeepSeek,V4-Pro 与 Codex 适配(2026-08-13):api-docs.deepseek.com/zh-cn/news/news260813
- DeepSeek,官方定价页:api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek,API 文档(thinking 与 reasoning_effort 参数):api-docs.deepseek.com/zh-cn/api/create-chat-completion
- DeepSeek,Claude Code 接入指南:api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- DeepSeek-V4.1-Flash-1017,权重页:huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- 阿里云百炼,Qwen3.8-Max 模型文档:help.aliyun.com/zh/model-studio/qwen3-8-max
- 智谱,GLM-5.3 发布文:z.ai/blog/glm-5.3
- GLM-5.3 许可证:huggingface.co/zai-org/GLM-5.3/raw/main/LICENSE
- 智谱,GLM-5.3-Flash 发布文:z.ai/blog/glm-5.3-flash
- GLM-5.3-Flash 许可证(MIT):huggingface.co/zai-org/GLM-5.3-Flash/raw/main/LICENSE
- SCMP,Kimi K3 上线 Amazon Bedrock 报道:scmp.com
- Kimi K3 模型卡与许可证:huggingface.co/moonshotai/Kimi-K3
- 每经(新浪财经转载),Kimi K3.1 Pro 发布快讯(2026-10-24):finance.sina.com.cn
- Kimi 平台,定价文档(K3.1 Pro 与 K3 上下文口径):platform.kimi.com/docs/pricing/chat
- Kimi 国际站价格页:platform.kimi.ai
- Kimi,K3.1 Pro 官方指南:platform.kimi.com/docs/guide/kimi-k3-1-pro-quickstart
- Kimi,上下文缓存计费规则:platform.kimi.com/docs/guide/context-caching
- Kimi,会员定价页:kimi.com/help/membership/membership-pricing
- Qwen3.8-2.4T-A95B 许可证(Qwen3.8-Max License):huggingface.co/Qwen/Qwen3.8-2.4T-A95B/raw/main/LICENSE
- Meta,Muse Spark Open 发布文:research.meta.ai/blog/muse-spark-open
- Meta,Muse Wonder 发布文(多模态输入、文本输出):research.meta.ai/blog/muse-wonder
- Inception,Mercury 3 发布文(常规 $0.20/$0.70,首发五折 $0.10/$0.35):inceptionlabs.ai/blog/introducing-mercury-3
- 阿里云,Prime 模式说明(GLM/Qwen 高速服务档):help.aliyun.com/zh/model-studio/prime-mode
- MiniMax,模型发布动态:platform.minimax.cn/docs/release-notes/models
- 财新,豆包大模型 2.0 报道:m.caixin.com
- SWE-bench 官方:swebench.com
- Epoch AI,SWE-bench Verified 基准页(任务子集与 scaffold 说明):epoch.ai/benchmarks/swe-bench-verified
- B 站互动站《AI 大模型世界》(程序员鱼皮,聚合 Epoch AI、models.dev、LiveBench、LMArena 等数据,726 个模型;单源条目未交叉校验,本文少数“聚合站口径”数据出自此处):bilibili.com/toy/ai-model-world
- Vals AI,指数方法说明:vals.ai/benchmarks/vals_index
- scaffold 对分数影响的系统分析:arxiv.org/html/2506.17208v2
- Cursor,BYOK 帮助文档:cursor.com/help/models-and-usage/api-keys
- LMArena 官方评分方法说明:arena.ai/blog/arena-rank
- Midjourney,V8.2 发布公告(7-24 起默认生成版本):updates.midjourney.com/version-8-2
- Midjourney,官方版本文档:docs.midjourney.com/hc/en-us/articles/32199405667853-Version
- Midjourney,V8.2 编辑模型 alpha 更新日志:updates.midjourney.com/alpha-changelog-9-2-26
- WritingBench 原始项目:github.com/X-PLUG/WritingBench
- Chinese-Writing-Bench 原始项目:github.com/zake7749/Chinese-Writing-Bench